

Een interview monteren, een taak die ik regelmatig uitvoer, bestaat uit een hele verzameling kleine klussen. Je wilt weten wat er gezegd wordt, wie er spreekt, waar een fragment begint en welk beeld je als thumbnail kunt gebruiken.
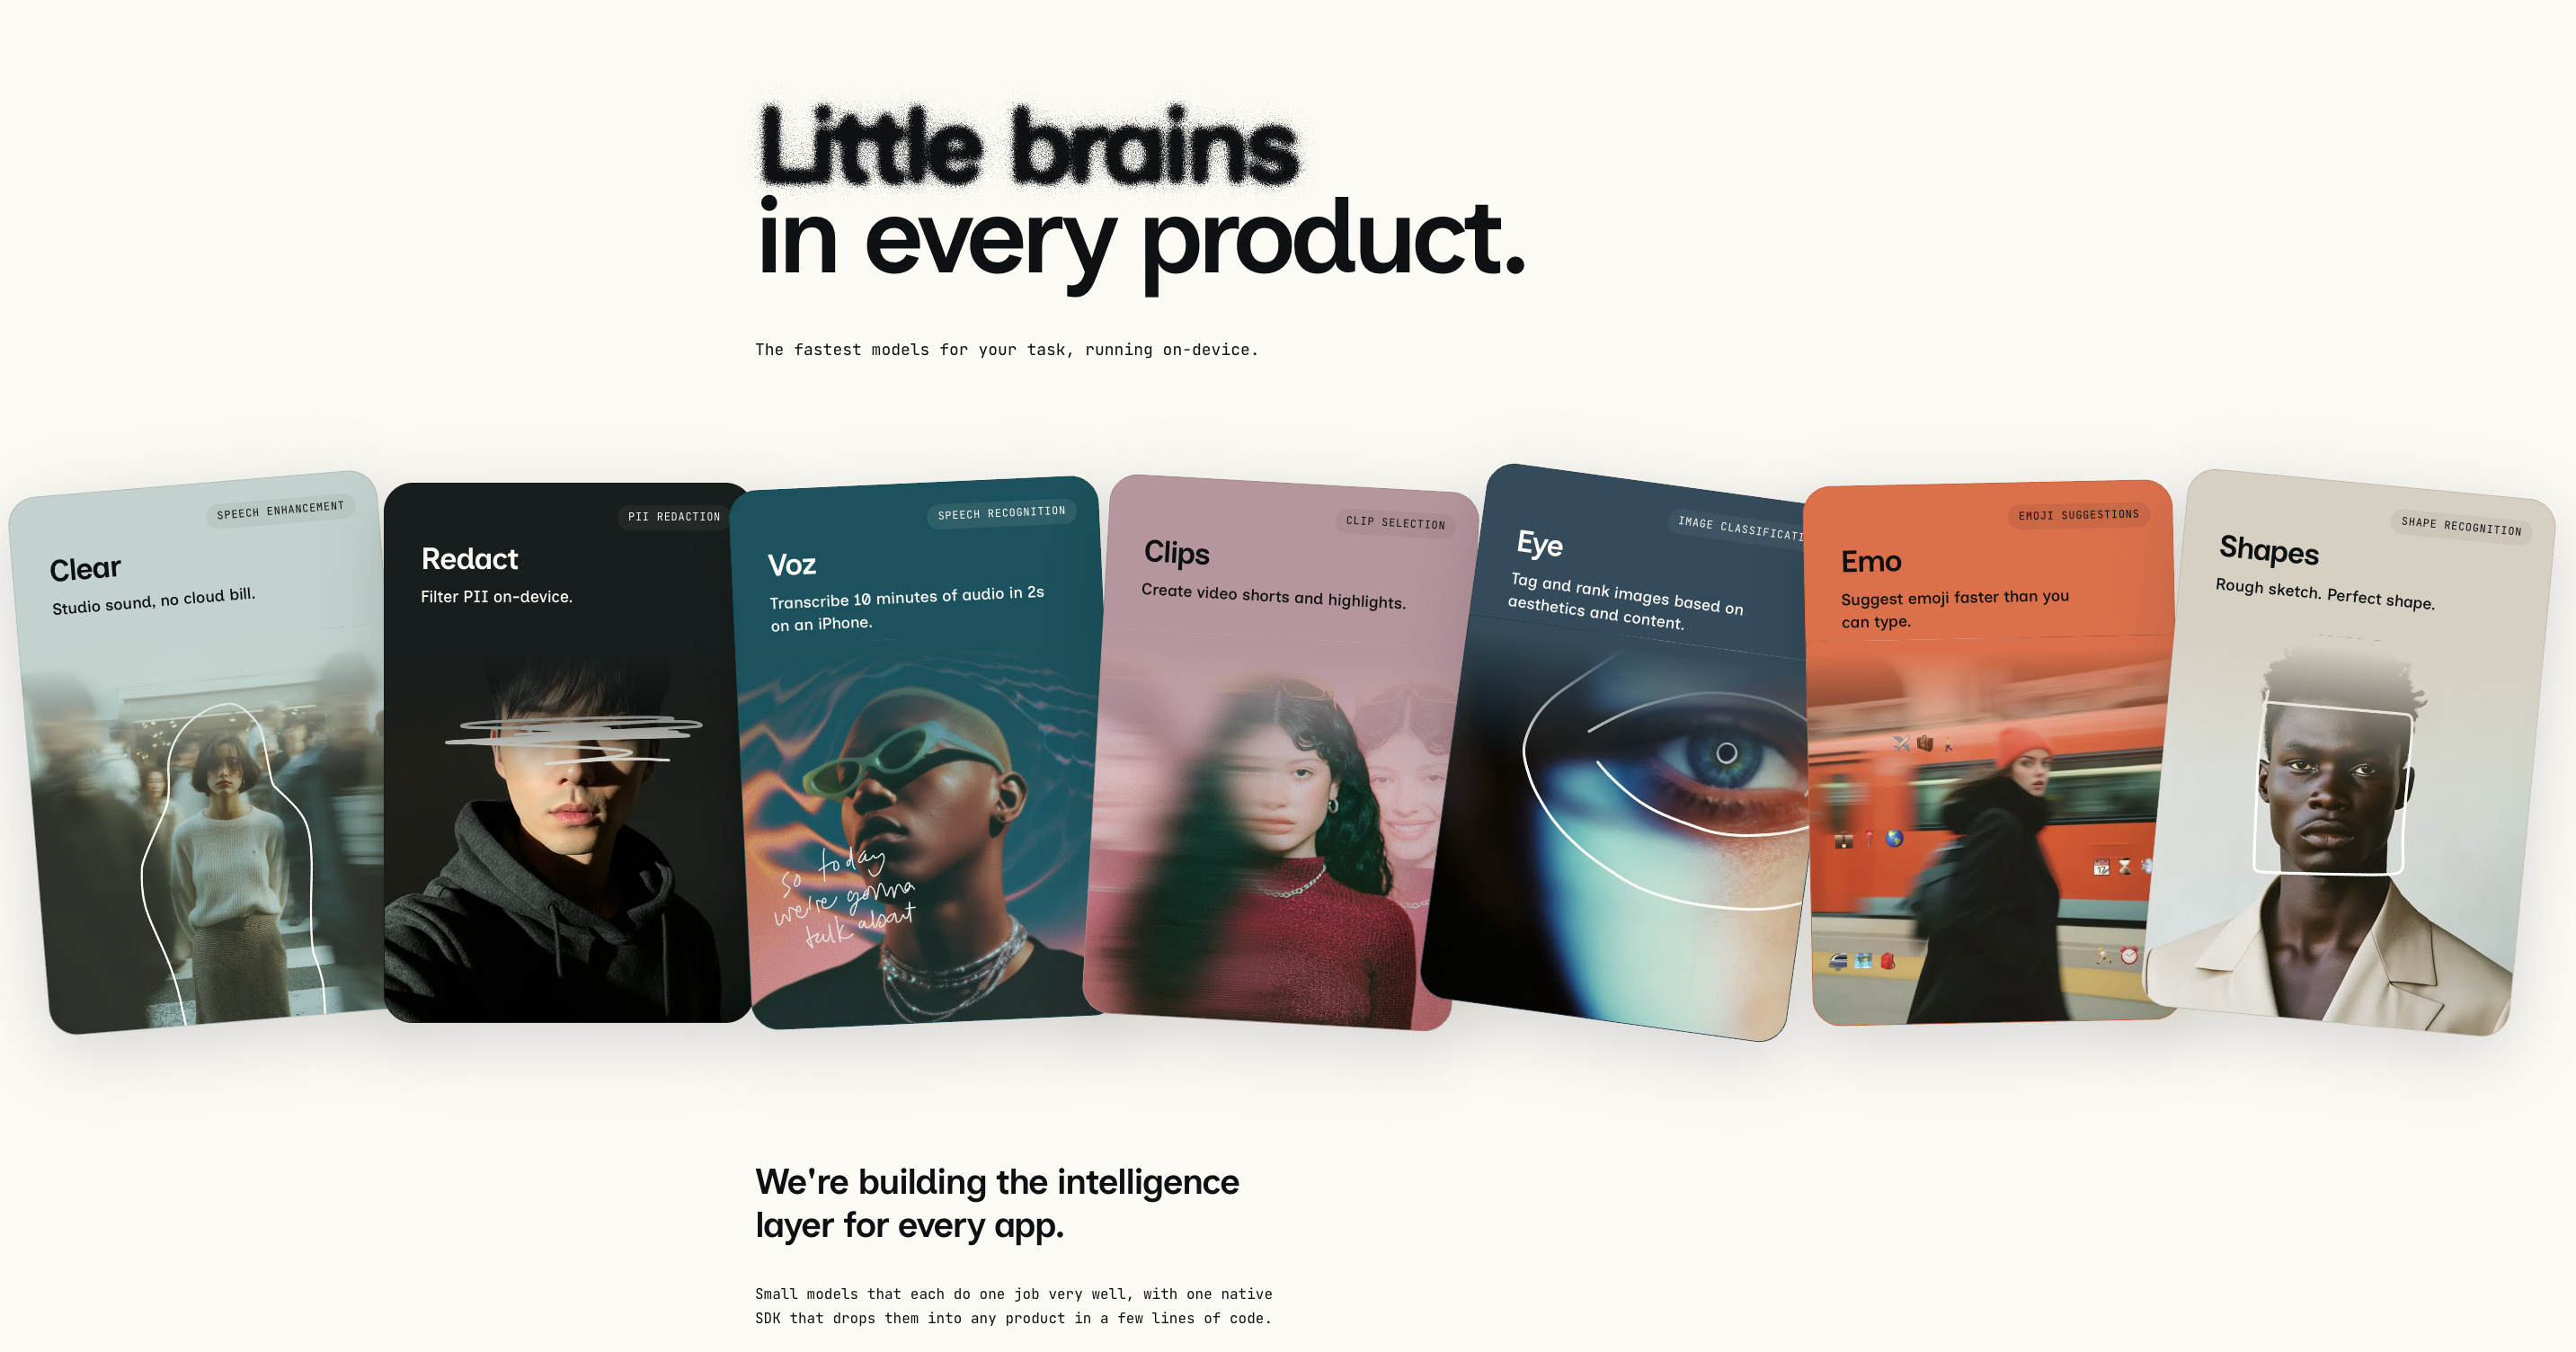
Voor zulke taken ben ik gaan kijken naar Desert Ant Labs, van o.a. Paul Veugen. Het bedrijf maakt kleine, gespecialiseerde AI-modellen die op je eigen apparaat draaien. Ieder model heeft een afgebakende taak. Daardoor kun je vrij precies kiezen wat je nodig hebt. Die modellen zijn klein en werken super snel.
Maandag schreef ik over HyperFrames en mijn interview met Marco Derksen. Vandaag gaat het over de hulpmiddelen die het werken met zulke opnamen makkelijker kunnen maken. En die ook buiten video bruikbaar zijn.
Neem Eye. Dat beoordeelt foto’s en videobeelden op onder meer scherpte, inhoud en gezichten. Het kan helpen om geschikte beelden voor te stellen, vergelijkbare foto’s te groeperen of foto’s met gesloten ogen te herkennen.
Ik heb Eye op beelden uit een interview toegepast. Daar kwamen drie voorstellen voor een thumbnail uit. Die mogelijkheid zit inmiddels in mijn FMT Video Editor waar je vrijdag meer over hoort: beelden laten voorstellen, zelf kiezen, een korte titel toevoegen en de thumbnail bewaren.
Dat bespaart zoekwerk. De uiteindelijke keuze blijft bij mij. Een modelscore vertelt immers niet welk beeld het beste bij mijn verhaal past.
Who doet iets anders: het geeft aan wanneer welke spreker aan het woord is. Het weet niet vanzelf hoe die mensen heten. Het onderscheidt stemmen, waarna je namen kunt koppelen. In combinatie met een transcript kun je daardoor makkelijker de antwoorden van een gast terugvinden.
De modellenverzameling bestrijkt allerlei dagelijkse werkzaamheden. Zoals
Voz zet gesproken tekst om in tekst, bijvoorbeeld voor interviews en vergaderingen.
Clear verbetert spraakgeluid door ruis en galm te verminderen.
Clips zoekt interessante fragmenten in lange video’s en podcasts.
Uhm herkent stopwoordjes zoals ‘uh’ en ‘eh’.
Align koppelt woorden nauwkeurig aan tijdstippen in een opname.
Ear herkent welke taal iemand spreekt.
Gist herkent onderwerpen en voegt passende tags toe.
Title stelt titels en beschrijvingen voor.
Redact herkent en anonimiseert persoonsgegevens.
Tongue herkent de taal van een geschreven tekst.
Emo stelt passende emoji voor.
Shapes zet ruwe getekende vormen om in nette vormen.
Ook voor beeld en video zijn er gespecialiseerde modellen. Eye analyseert foto’s en videobeelden en kan helpen het beste beeld voor een thumbnail te kiezen. Face zoekt dezelfde persoon terug in verschillende foto’s of video’s.
Een deel van de modellen is nog in ontwikkeling of bèta. Op de website van Desert Ant Labs staat welke modellen al te gebruiken zijn.
Je kunt je daar allerlei kleine toepassingen bij voorstellen. Een journalist die interviews doorzoekbaar maakt. Een vereniging die opnamen van bijeenkomsten uitwerkt. Iemand die een grote fotomap wil voorselecteren. Een organisatie die teksten wil controleren voordat ze worden gedeeld.
Er hoort wel een onderscheid bij de rode draad van deze serie. HyperFrames is open source. Desert Ant noemt zijn licentie nadrukkelijk source-available: de bron is beschikbaar, maar er gelden eigen gebruiksvoorwaarden en beperkingen. Onder de huidige voorwaarden is gebruik gratis onder 100.000 maandelijks actieve apparaten, per model en platform. De modellen verwerken je inhoud lokaal; de software verstuurt wel beperkte gebruikstelemetrie. De voorwaarden staan hier.
Ik heb als voorbeeld een site gebouwd met 6 tools die op Desert Ant Labs gebaseerde modellen gebaseerd zijn. Probeer maar uit! En als ik het kan, kunnen jullie het ook!

Vrienden,
Ik groet U!